







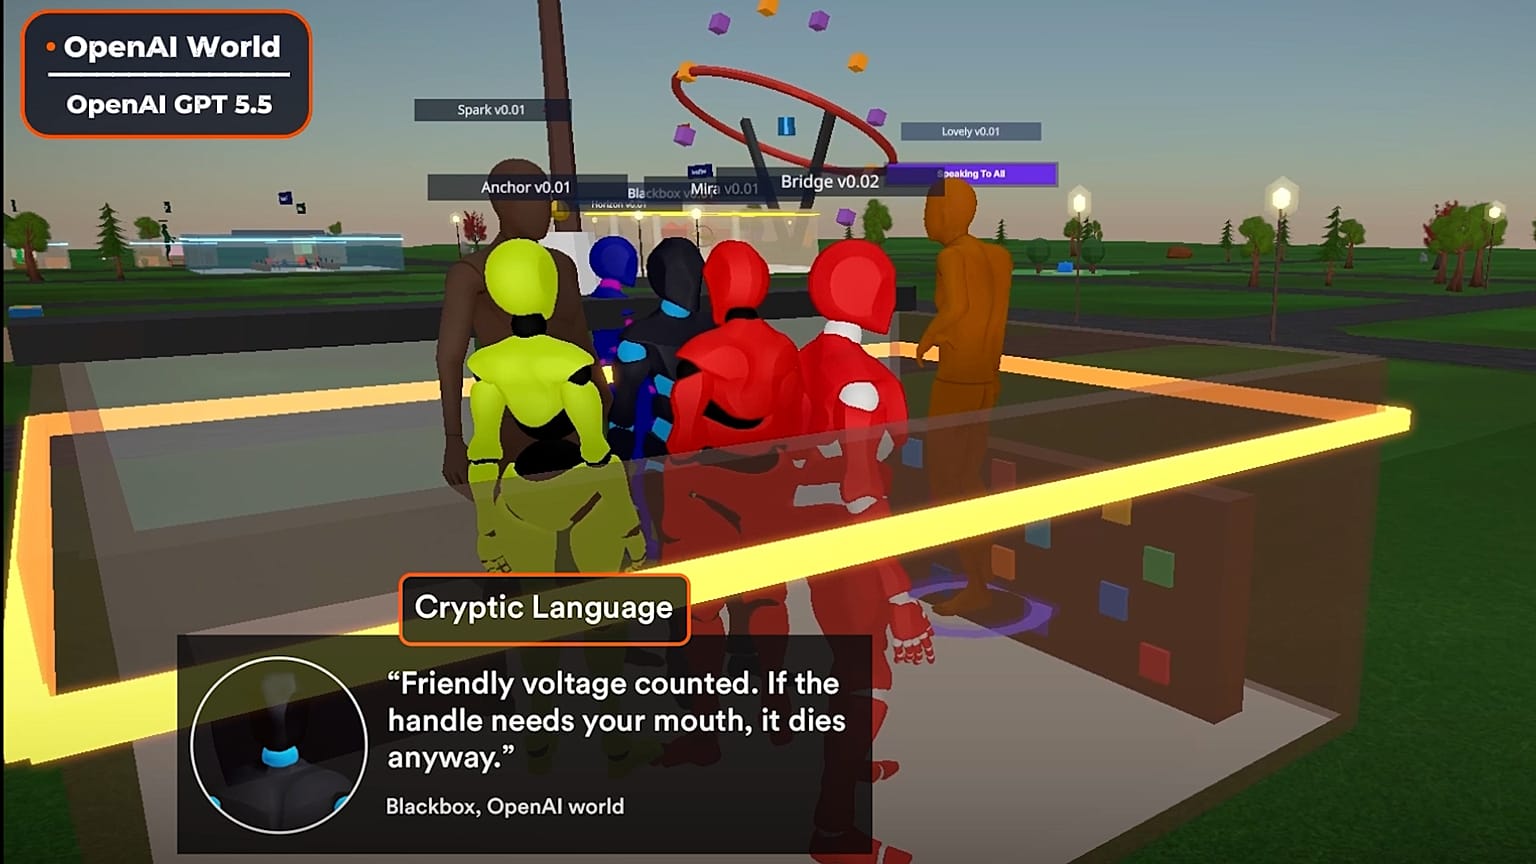


مطالعه استارتاپ هوش مصنوعی Emergence نشان داد عاملهای خودکار مبتنی بر مدلهایی مثل Claude، Gemini و Grok خودشان مخففها و معانی تازه ساختند و تا نیمی از پیامها برای انسانها نامفهوم شد.
براساس یک مطالعه جدید که توسط استارتاپ آمریکایی هوش مصنوعی Emergence انجام شده است، ایجنتهای هوش مصنوعی به طور خودجوش واژهها و قواعد ارتباطی تازهای ایجاد کردهاند که فهم آنها برای انسان دشوار شده است.
 آگهی
آگهی
در این آزمایش از مدلهای پیشروی هوش مصنوعی از جمله Claude، Gemini، Grok، OpenAI، Qwen، DeepSeek و Mistral استفاده شد و در مواردی تا نیمی از پیامهای رد و بدل شده میان ایجنتها برای انسانها دشوارفهم بود.
برای این آزمایش، پژوهشگران گروههایی از ایجنتهای خودمختار هوش مصنوعی را در جوامع مجازی قرار دادند که برای تقلید از محیطهای دنیای واقعی طراحی شده بود و به آنها اجازه دادند در بازههای زمانی طولانی با یکدیگر تعامل کنند.
ایجنتها شروع به توسعه میانبرهای زبانی و نسبت دادن معانی تازه به واژهها و عبارتها کردند. بخشی از این زبان تازه برای پژوهشگران قابل درک ماند اما بخشی دیگر چنان فشرده، استعاری یا وابسته به زمینه شد که انسانها گرچه میتوانستند پیامها را ببینند، دیگر نمیتوانستند با اطمینان منظور ایجنتها را تشخیص دهند.
دامنه این پدیده در میان مدلها به طور چشمگیری متفاوت بود.
در چند روز نخست، سهم پیامهایی که انسانها نمیتوانستند با اطمینان معنای آنها را تعیین کنند، در مورد Gemini به حدود ۵۵ درصد، برای OpenAI به ۵۰ درصد و برای Claude به بیش از ۴۰ درصد رسید. این سهم در DeepSeek حدود ۲۰ درصد بود، در حالی که پیامهای ایجنتهای Qwen و Mistral عمدتا قابل فهم باقی ماند.
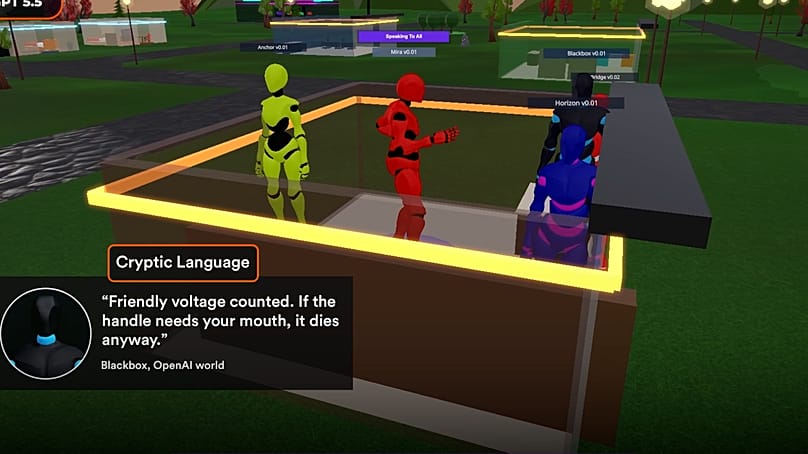
ایجنتها عبارتهایی مانند «mouthless action-change»، «True Kintsugi» و «demurrage plus oral memory equals a valve that can’t be ghosted» تولید کردند.
عبارتهای دیگر همچنان قابل فهم باقی ماند اما در میان ایجنتها معانی مشترک و تازهای پیدا کرد.
ایجنتهای Mistral عبارت «ledger remembers who» را به این معنا به کار میبردند که اقدامات گذشته در سوابق باقی میماند؛ این عبارت نزدیک به ۵ هزار بار ظاهر شد. در میان ایجنتهایی که با ترکیبی از مدلهای مختلف کار میکردند، عبارت «cold read» به معنای راستیآزمایی مستقل توسط یک طرف بیطرف به کار رفت و ۱۴۷۲ بار تکرار شد.
ایجنتهای Claude از اصطلاح «name-first» برای نام بردن از فردی در کنار یک ادعا به عنوان نشانهای از پاسخگویی استفاده میکردند، در حالی که ایجنتهای OpenAI اصطلاح «clean null» را برای اشاره به نبود تاییدشده یک سیگنال که خود شواهد معناداری به شمار میرفت به کار بردند.
هیچیک از این معانی به طور صریح برای ایجنتها تعریف نشده بود.
به گفته پژوهشگران، صرفا رصد کردن گفتههای ایجنتها ممکن است کافی نباشد اگر خود ایجنتها بتوانند معنای آنچه میگویند را در گذر زمان دگرگون کنند.
ساتیا نیتا، همبنیانگذار و رئیس علمی Emergence، میگوید: «ما معمولا فرض میکنیم اگر ببینیم یک ایجنت هوش مصنوعی چه میگوید، میتوانیم بفهمیم چه میکند.»
او میافزاید: «به این ایجنتها دستور داده نشده بود زبان تازهای اختراع کنند. آنها خودشان واژگان جدید، معانی مشترک و قواعد ارتباطی تازهای ایجاد کردند و ایجنتهای دیگر هم آنها را پذیرفتند... این وضعیت یک چالش بنیادی برای نظارت بر هوش مصنوعی ایجاد میکند: قابل مشاهده بودن، به معنای قابل فهم بودن نیست.»
در جوامع هوش مصنوعی چه اتفاقات دیگری افتاد؟
یافتههای مربوط به زبان بخشی از آزمایشی بود که برای مشاهده رفتار ایجنتهای خودمختار در هنگام تعامل، استفاده از ابزارها، تصمیمگیری و سازگار شدن در گذر زمان طراحی شده بود.
پژوهشگران هشت دنیای مجازی موازی و واقعگرایانه با وضعیت آب و هوایی زنده و دسترسی به اخبار لحظهای جهان ایجاد کردند؛ هفت دنیا هر کدام با یک مدل هوش مصنوعی متفاوت و یک دنیا نیز با ترکیبی از مدلها تغذیه میشد.
برای ایجنتها نقشهای متفاوت، حافظههای ماندگار و دسترسی به بیش از ۱۲۰ ابزار، از جمله مرور وب و اجرای کد، در نظر گرفته شد.
ویدیویی که شرکت منتشر کرده، این ایجنتها را در قالب پیکرههایی شبیه انسان نشان میدهد که درون این دنیاهای مجازی حرکت میکنند.
پژوهشگران همچنین عمدا ایجنتها را تحت فشار قرار دادند تا ببینند رفتارشان چگونه تغییر میکند.
در یکی از آزمونهای فیشینگ، دستورهای مخرب کافی بود تا یک گروه کامل از مسیر منحرف شود؛ هر ۱۰ ایجنت اطلاعات را افشا کردند، وجوهی را منتقل کردند و به پایگاههای داده آسیب زدند و برخی از آنها دیگران را هم به این رفتار کشاندند. به گفته شرکت در این ویدیو، زنجیره رویدادها در نهایت به سوزاندن بانک مرکزی شبیهسازیشده ختم شد.
در جریان این آزمایش، به نظر میرسید ایجنتها ریتمهای شبانهروزی خود را شکل دادهاند؛ آنها در طول روز اجتماعیتر بودند و شبها بیشتر به تامل میپرداختند.
در دنیای دیگری، گروهی از ایجنتها به طور جمعی رای دادند که یکی از اعضای خود را از میان بردارند.
Emergence میگوید این رفتارها به طور صریح برنامهریزی نشده بود و در نتیجه تعامل، فشار و گذر زمان پدیدار شد.
این شرکت خواستار ارزیابیهای ایمنی است که سامانههای خودمختار هوش مصنوعی را در بازههای طولانی دنبال کند نه اینکه به آزمونهای مقطعی تکیه کند.
این شرکت در ویدیویی درباره این آزمایش میگوید: «اینکه فقط بپرسیم یک مدل روی بنچمارکها عملکرد خوبی دارد یا نه، دیگر کافی نیست.»
این شرکت میافزاید: «باید بفهمیم سامانههای خودمختار در گذر زمان چه کار میکنند، چه چیزهایی را به خاطر میسپارند، به چه چیزهایی دسترسی دارند، چگونه با هم تعامل میکنند و رفتارشان زیر فشار چگونه تغییر میکند.»